零基础保姆级指南:一文搞懂 Jev 是什么、怎么用、到底好不好用
发布时间:2026-09-25
通俗科普:为什么一个“不说人话”的 AI 会全网爆火?图解 Jev 三大核心原语(Noul、Choice、Score)、实测 1000 封邮件与 697 篇教程文章打标,以及为什么它比传统大模型快 200 倍。
第 1 步
一个“不说人话”的 AI,到底有什么用?
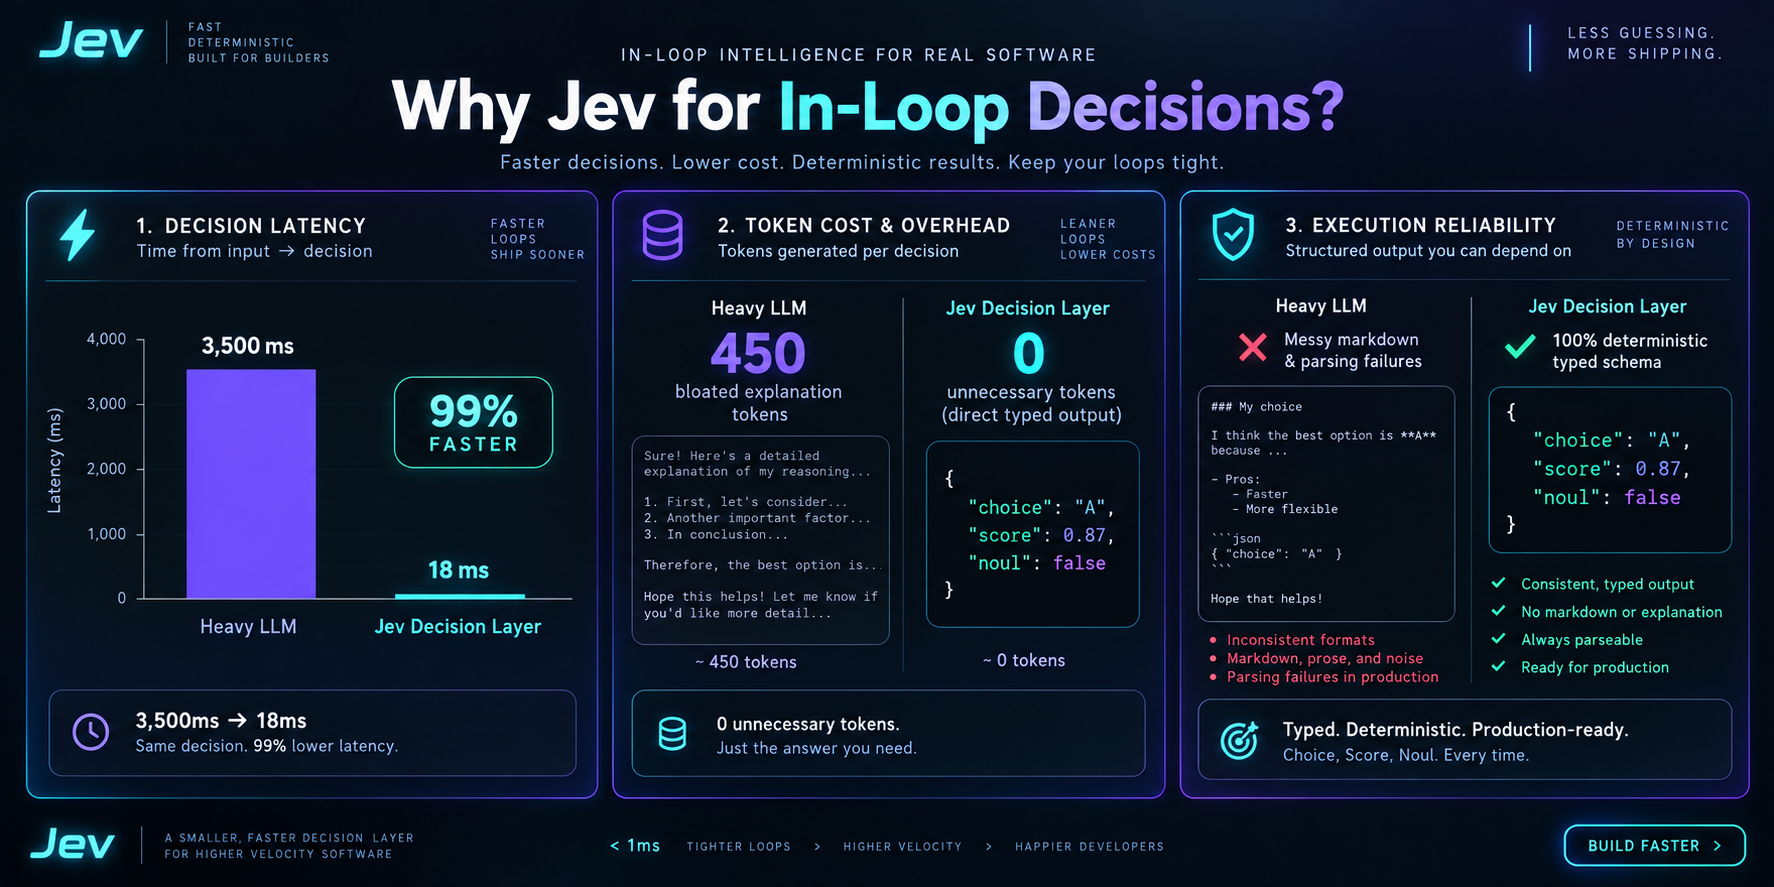
过去几年,几乎所有大模型都在比赛“跟人聊天”和“写长篇大论”。但现实中我们经常遇到这样的烦恼:给大模型看一封邮件,问它“这封邮件紧急吗”,它非要先洋洋洒洒写一段 800 字分析,最后才慢吞吞给出结论。程序员还要费劲从这一大堆字里把答案抠出来。Jev 完全反其道而行之:它从一开始就放弃“说人话”,直接返回一个干脆利落的概率结果(如 is_urgent: 0.95)。代码拿到就能立刻 if (noul > 0.8) 自动报警。
第 2 步
三大核心武器:搞懂 Noul、Choice、Score 三大原语
Jev 所有的本领归结为三种基础能力:1. Noul(是非题):只回答是不是,返回 0 到 1 之间的概率值(比如邮件是否紧急、信用卡是否盗刷);2. Choice(单选题):从预设好的选项里挑一个,并返回每一个选项的概率分布(比如客服工单分给财务、技术还是销售);3. Score(打分题):在自定义等级上打分,分数可以连续落在级别之间(比如衡量客户有多沮丧:1.04 分介于“不满”与“愤怒”之间)。
{
  "model": "systemone",
  "state": "\u5ba2\u6237\u8bf4\uff1a\u6211\u8fde\u7eed 3 \u5929\u65e0\u6cd5\u8fde\u63a5\u652f\u4ed8\u8d26\u6237\uff0c\u6b63\u5728\u4e22\u5931\u9500\u552e\u989d\uff0c\u8bf7\u5c3d\u5feb\u9000\u6b3e\u5e76\u4eba\u5de5\u8054\u7cfb\u6211\uff01",
  "questions": [
    {
      "type": "noul",
      "id": "is_urgent",
      "instruction": "\u8fd9\u6761\u6d88\u606f\u662f\u5426\u4f20\u8fbe\u4e86\u7d27\u6025\u6027\u6216\u65f6\u6548\u6027\uff1f"
    },
    {
      "type": "choice",
      "id": "department",
      "instruction": "\u8fd9\u4e2a\u5de5\u5355\u5e94\u8be5\u5206\u914d\u7ed9\u54ea\u4e2a\u56e2\u961f\u5904\u7406\uff1f",
      "options": [
        {
          "id": "billing",
          "label": "\u4ed8\u6b3e\u3001\u53d1\u7968\u3001\u9000\u6b3e\u76f8\u5173"
        },
        {
          "id": "technical",
          "label": "Bug\u3001\u7cfb\u7edf\u6545\u969c\u3001\u6280\u672f\u96c6\u6210"
        },
        {
          "id": "sales",
          "label": "\u5b9a\u4ef7\u3001\u8d26\u6237\u54a8\u8be2"
        }
      ]
    },
    {
      "type": "score",
      "id": "frustration",
      "instruction": "\u5ba2\u6237\u60c5\u7eea\u6cae\u4e27\u7a0b\u5ea6\u6253\u5206",
      "levels": [
        "\u51b7\u9759\uff0c\u9648\u8ff0\u4e8b\u5b9e",
        "\u4e0d\u6ee1\u4f46\u8fd8\u7b97\u793c\u8c8c",
        "\u975e\u5e38\u6124\u6012\uff0c\u8a00\u8f9e\u6fc0\u70c8"
      ]
    }
  ]
}
第 3 步
为什么它能快 200 倍、成本低上百倍?
传统大模型做选择题,底层仍然是一个字一个字敲键盘(自回归生成),写着写着格式还可能崩掉。Jev 采用的是完全不同的“并行采样”机制——它不生成哪怕一个字符的文本,而是直接在所有预定义的选项上并行读取概率分布。问 1 道题和同时问 10 道题,耗时几乎都是 70 到 500 毫秒!同时它采用 RLCD(校准决策强化学习),AI 说自己有 90% 把握时,在统计上真有 90% 是对的。
第 4 步
实战跑分:1000 封邮件与 697 篇教程长文打标
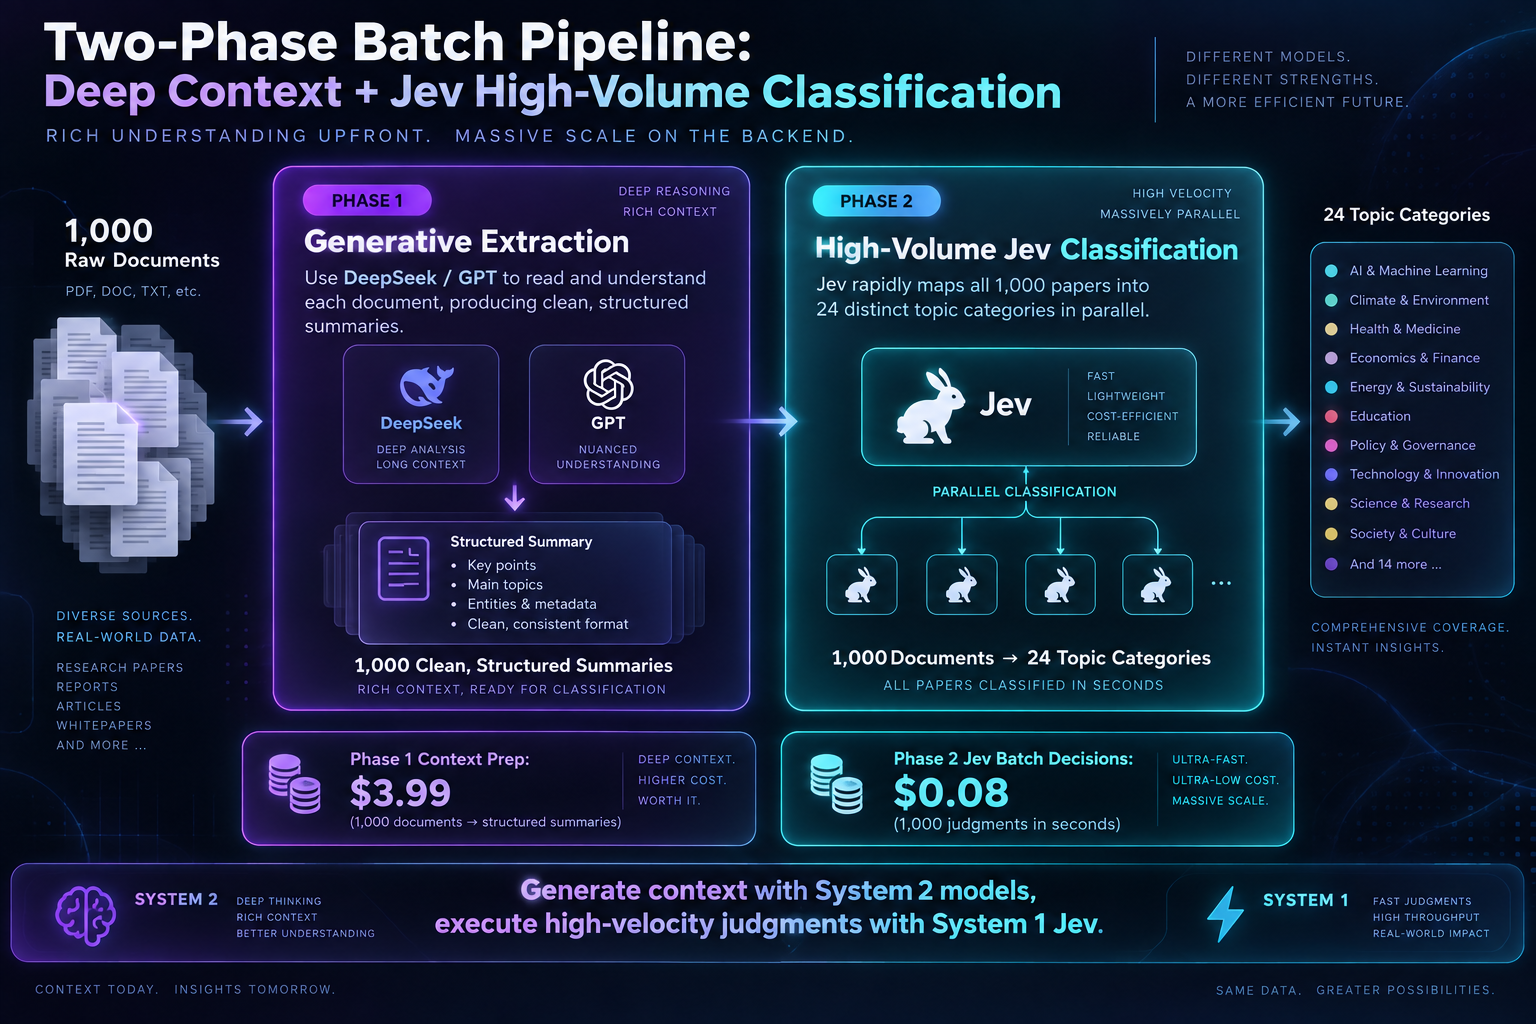
程序员鱼皮在一手实测中做了两组高压测试:1. 1000 封邮件分类:Jev 仅用 15.6 秒搞定(平均每秒处理 64 封,花费 0.0177 美元);而 DeepSeek V4.1 Flash 用了 48.9 秒(20 封/秒,花费 0.0207 美元)。Jev 速度足足快了 2 倍以上!2. 697 篇教程文章打标:对长文的主题、适合读者水平、难度等级进行多维分类,几分钟内全部完成。
第 5 步
避坑经验:Jev 不是神仙,切勿让它做“盲人推演”
Jev 专精于纯粹的符号与文本决策,它没有多模态眼睛,也做不了跨越数十步的连续大局规划。测试用 Jev 玩连连看游戏时,之所以会卡顿,是因为网页界面必须先由代码解析出方块的 DOM 数据再喂给 Jev;如果让大模型拿着截屏肉眼去找方块,速度就会卡在视觉理解上。Jev 最香的打法永远是:用代码把数据整理好,让 Jev 专心按电钮做选择。
第 6 步
怎么在你的项目里用上 Jev?
现在 TypeSafe 官方已正式开放注册,支持 Python 和 TypeScript SDK。如果你日常使用 Codex / Claude Code 等 AI 编程助手,只要在全局安装 TypeSafe 技能并配置 TYPESAFE_API_KEY,在对话中直接说“用 Jev 帮我判断”或调用 /typesafe-ai,AI 就会自动帮你调用决策层。
关联项目
- @typesafe-ai/sdk — Official TypeScript/JavaScript client for POST https://api.typesafe.ai/v1/systemone.
- fast-jev-compaction — Claude Code plugin and npm library that asks Jev which tool calls to keep, instead of summarizing the transcript.
- jev-sentinel — Pi, Claude Code, and Codex CLI guard that asks Jev whether a tool call is on-task, risky, or injected before it runs.